 Olivier Guillaume - 17 nov. 2026
Rendre un PO autonome jusqu'à la prod : ce qu'il faut réunir, ce qui reste au dev
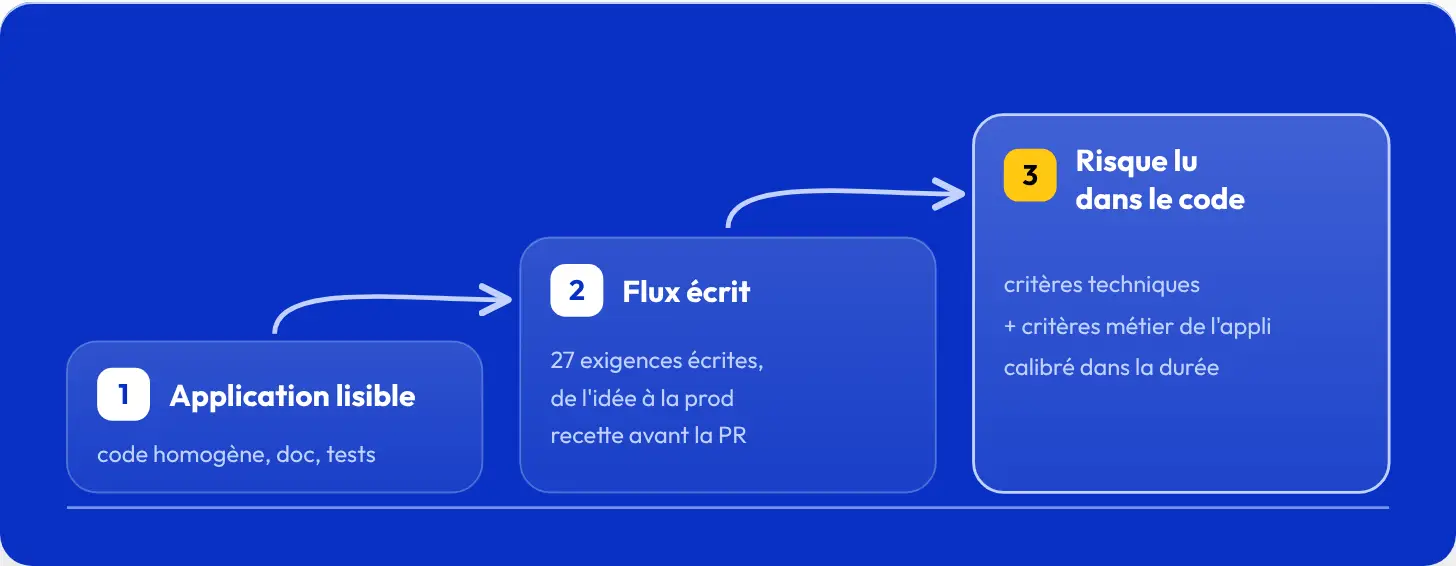
Un PO peut livrer en prod avec l'IA. Pas seul, pas tout de suite, et pas sur n'importe quelle application. C'est d'abord un problème de flux, au sens du Lean : repérer où le travail attend, puis le faire circuler sans dégrader la qualité. Il faut réunir trois choses, dans cet ordre : une application lisible (code homogène, documentation, tests automatisés), un flux de livraison écrit noir sur blanc, puis une évaluation du risque qui s'appuie sur ce que le code touche. Ce qui reste au dev : construire cette chaîne et rester garant de ce qui part en prod.
Je suis directeur du delivery chez exFabrica. Sur Lysia, notre ERP interne, utilisé par 40 personnes au quotidien, j'ai aussi le rôle de Product Owner. C'est là que je l'ai vécu. Voici ce que j'en retiens, étape par étape.
Le goulot se déplace : de la dispo des devs vers le PO
Pour rendre un PO autonome, il faut d'abord savoir ce qui le bloque. Sur Lysia, la réponse était simple : la disponibilité des développeurs.
Chaque évolution, même petite, dépendait d'un développeur qui connaissait l'application. Donc du staffing. Il y avait des périodes où l'on avançait. Et d'autres où c'était impossible, parce que personne n'était disponible. Le besoin métier, lui, ne s'arrête pas. Les demandes s'accumulent. Le PO sait ce qu'il faut faire, mais il attend. En Lean, c'est le premier des gaspillages : de l'attente pure.
Une fois cette attente levée, le goulot ne disparaît pas. Il se déplace vers le PO. Comprendre le besoin, le spécifier, maquetter, recetter : tout cela reste à sa charge. Et comme on livre plus vite, il a plus de travail qu'avant, pas moins.
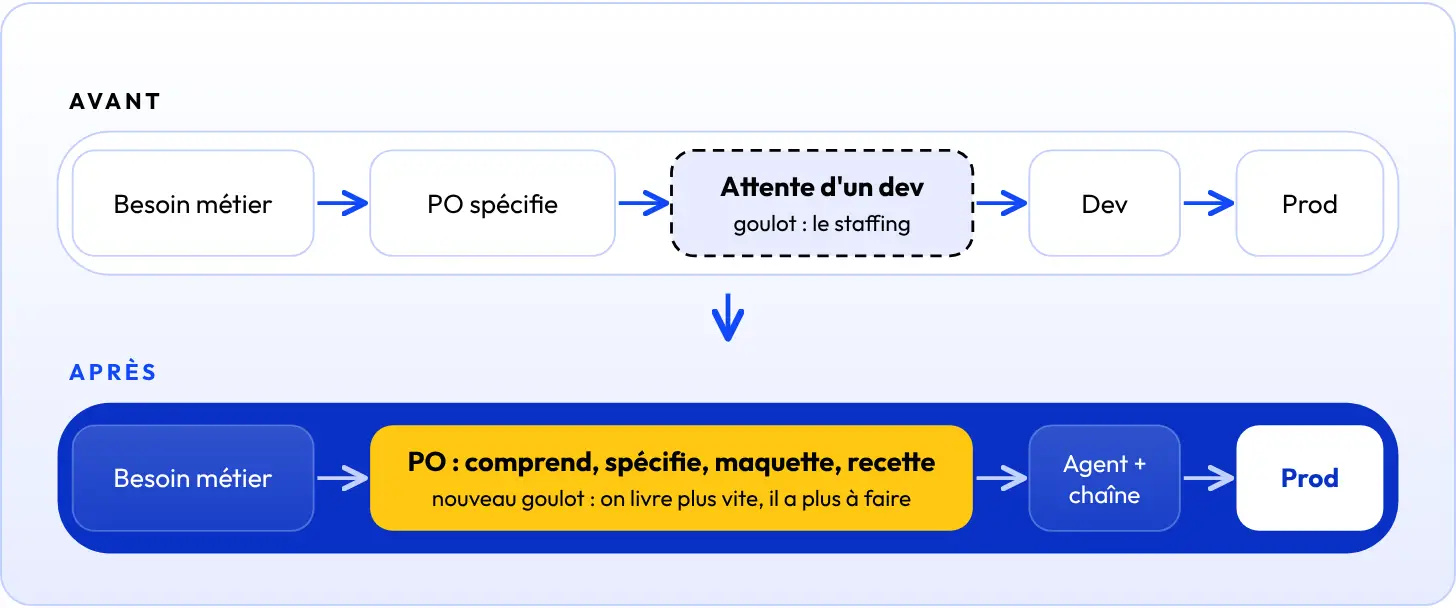
Ma leçon : avant de chercher à rendre un PO autonome, regardez où se trouve l'attente. Si elle vient de la dispo des devs, l'objectif n'est pas de remplacer le dev. C'est de ne plus dépendre de sa présence pour chaque petite évolution. Mais prévoyez la suite : le rythme sera fixé par la capacité du PO à comprendre et à spécifier le besoin.
Standardiser avant d'automatiser
C'est l'étape qu'on a envie de sauter. Il ne faut pas. Une IA qui travaille sur un code hétérogène, sans documentation et sans tests, produit des changements que personne ne peut vérifier.
Sur Lysia, on a commencé par moderniser. Trois chantiers :
- homogénéiser les technologies ;
- rétro-documenter l'existant ;
- mettre en place des tests automatisés qui tournent à chaque build.
Seul le front a été modernisé. La méthode a compté autant que l'outil. Le lead tech a d'abord migré quelques pages lui-même, pour fixer la manière de faire. C'est un principe Lean de base : on fixe le standard avant d'accélérer. Ensuite, les agents ont migré le reste en 16 h, pour 1 milliard de tokens.
Ce chiffre impressionne. Mais ce n'est pas lui qui a coûté le plus. Le plus coûteux a été la recette. Elle a fait remonter des tests OK, et d'autres KO. Tout a été traité avant la mise en prod.
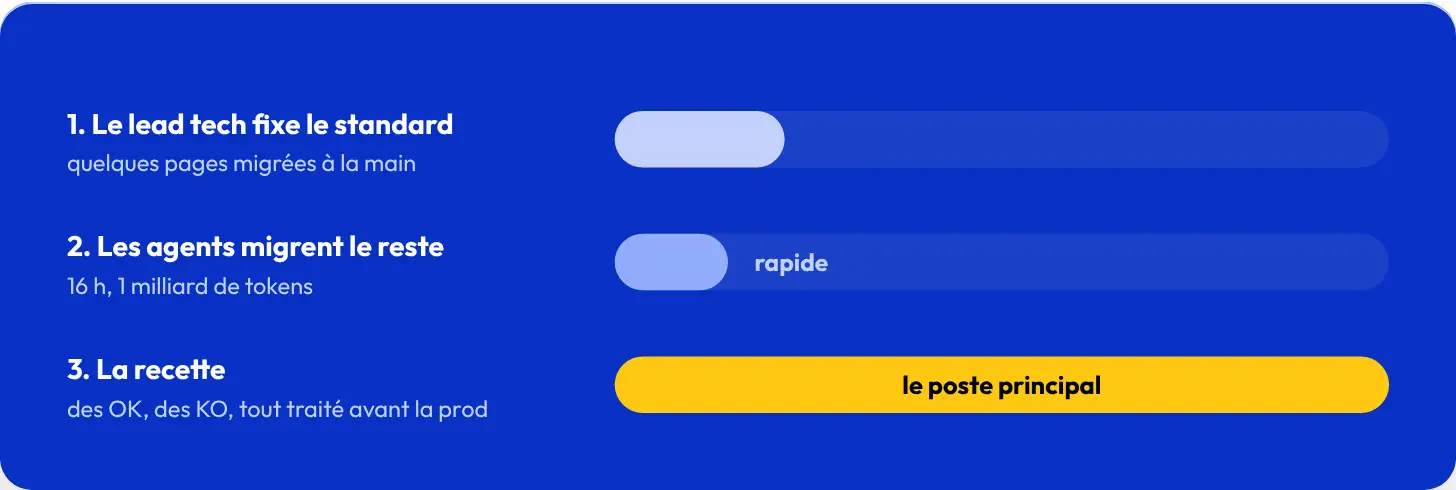
Ma leçon : la migration par les agents va vite, la vérification non. Si vous planifiez une modernisation de ce type, budgétez la recette comme le poste principal. Et faites fixer le standard par un humain sur quelques cas avant de lâcher les agents sur le reste.
Intégrer la qualité au flux
Une fois l'application lisible, il faut un cadre. Pas une intention générale, un cadre écrit.
Le 28/09/2026, on a posé 27 exigences pour le flux qui va de l'idée à la prod. En voici l'essentiel :
- une maquette HTML construite sur la base des écrans existants ;
- une validation de l'impact sur le modèle de données ;
- une branche nommée et des changements tracés ;
- des tests automatisés ;
- une recette avant la PR, pas après ;
- une fiche de changement : pourquoi, intention, règles métier, impacts ;
- une revue humaine des PR, dosée selon le risque ;
- une documentation mise à jour ;
- une autonomie qui grandit avec la confiance.
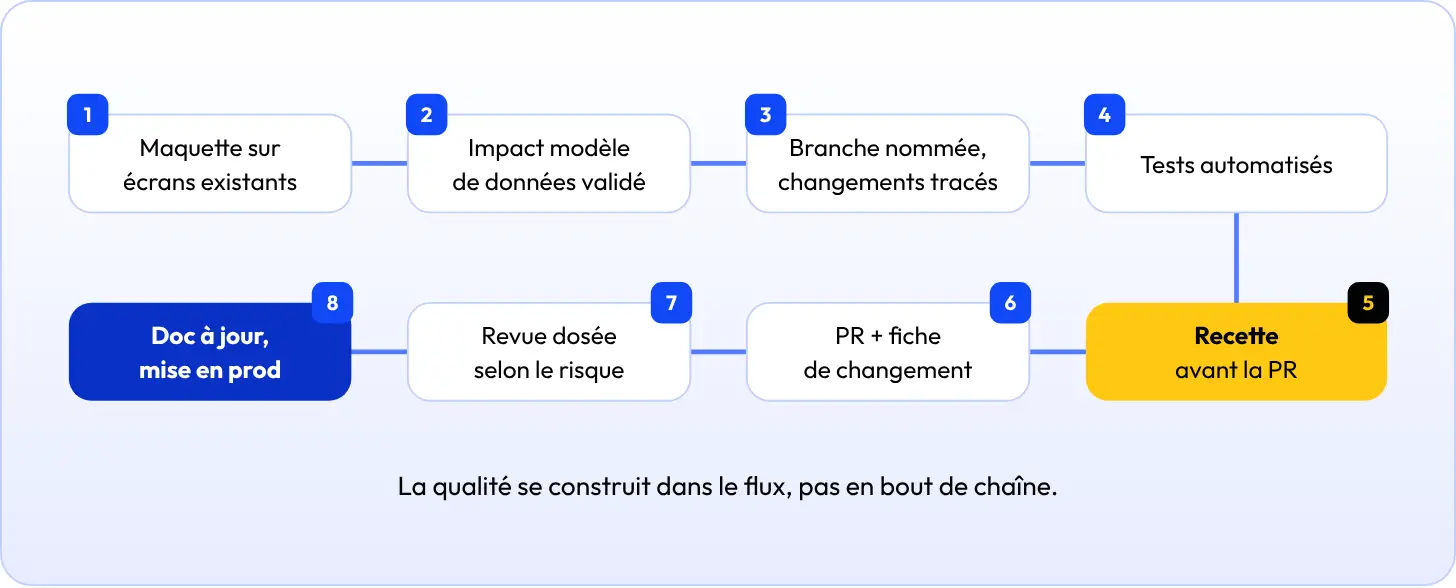
Le fil conducteur est celui du Lean : la qualité se construit dans le flux, pas en bout de chaîne. Un défaut trouvé en recette avant la PR coûte une correction. Le même défaut trouvé en prod coûte un incident.
Le dernier point de la liste est à mon avis le plus important. L'autonomie ne se décrète pas. Elle se gagne, livraison après livraison, par petites améliorations. Un exemple : au départ, chaque PR était relue. Aujourd'hui, les PR vertes ne le sont plus. Le cadre doit le dire explicitement, sinon on oscille entre deux excès : tout contrôler ou tout laisser passer.
Ma leçon : écrivez vos exigences avant la première livraison. Mettez la recette avant la PR. Et prévoyez dès le départ que le niveau d'autonomie va évoluer.
Le PO gagne en amont et en réactivité
Le premier gain n'a pas été là où je l'attendais. Il est en amont.
Je maquette maintenant moi-même, sur la base des écrans existants. Résultat : beaucoup moins d'allers-retours. Les utilisateurs réagissent sur quelque chose de concret. Les malentendus apparaissent avant le développement, pas pendant la recette. Chaque aller-retour évité, c'est de l'attente et de la retouche en moins.
Le deuxième gain, c'est la réactivité. Un diagnostic de prod a été fait le 08/10. La correction était en prod le 09/10 à midi. Avant, ce délai dépendait de qui était disponible.
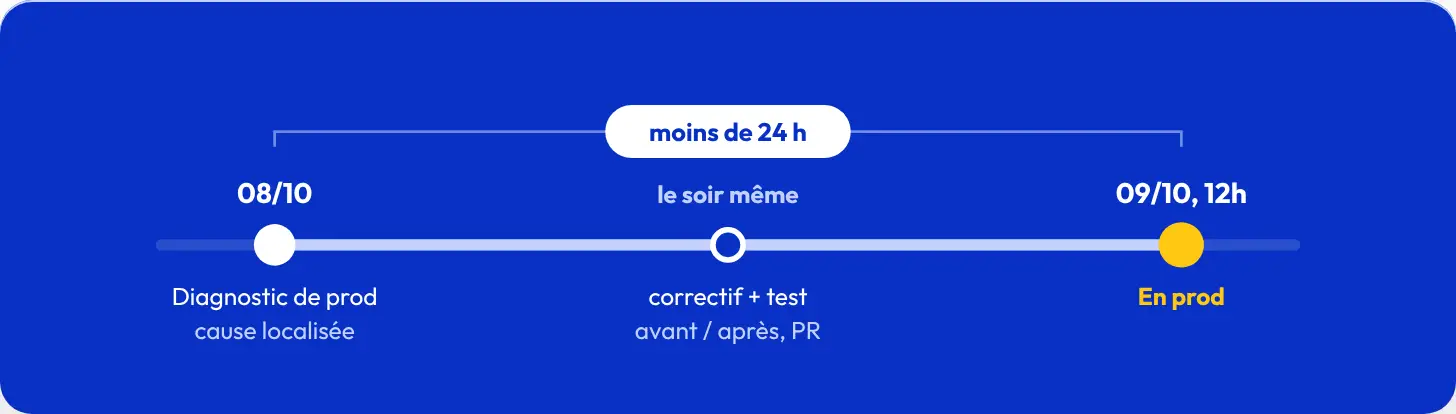
Il y a aussi des gains plus inattendus. Les vidéos de présentation des nouveautés sont désormais générées. Et une évolution conséquente, le pilotage de la satisfaction client des projets, a été réalisée presque entièrement par itérations entre l'IA et moi. Elle touchait toutes les couches : un questionnaire, des notifications Slack, une nouvelle table en base, un nouvel onglet de monitoring et des droits d'accès.
Ma leçon : ne mesurez pas seulement le temps de développement. Mesurez le délai de bout en bout, du besoin à la prod. Le temps perdu en allers-retours avant le développement y pèse souvent plus lourd. C'est là que le PO autonome apporte le plus.
Doser la revue selon le risque, et lire ce risque dans le code
On évalue chaque changement avec une grille en trois niveaux : vert, orange, rouge. Cette couleur ne décide pas qui livre. Elle décide de l'attention portée à la PR. Depuis peu, les PR vertes ne sont plus relues. C'est un principe Lean : proportionner le contrôle au risque, plutôt que tout inspecter de la même façon.
Encore faut-il que la grille soit juste. Au départ, elle était trop prudente. Du 06/10 au 20/10, sur 11 dossiers, 1 seul a été classé vert. Si presque tout est orange ou rouge, presque chaque PR demande une revue attentive. L'autonomie n'existe que sur le papier. Le lead tech redevient le passage obligé, et on retrouve le goulot du début.
Le problème venait de la source : on évaluait le risque à partir de la description du besoin. Pas à partir de ce que le changement touche réellement. Le risque doit se déduire du code : les droits, les rôles, le modèle de données, les écrans.
Mais une grille entièrement générique ne suffit pas. Chaque application a ses zones sensibles, liées à son métier. Sur Lysia, notre ERP, tout changement qui touche une règle de gestion pouvant affecter les chiffres financiers est rouge. Ce critère est propre à Lysia. Sur une autre application, il n'aurait pas de sens, et d'autres critères le remplaceraient.
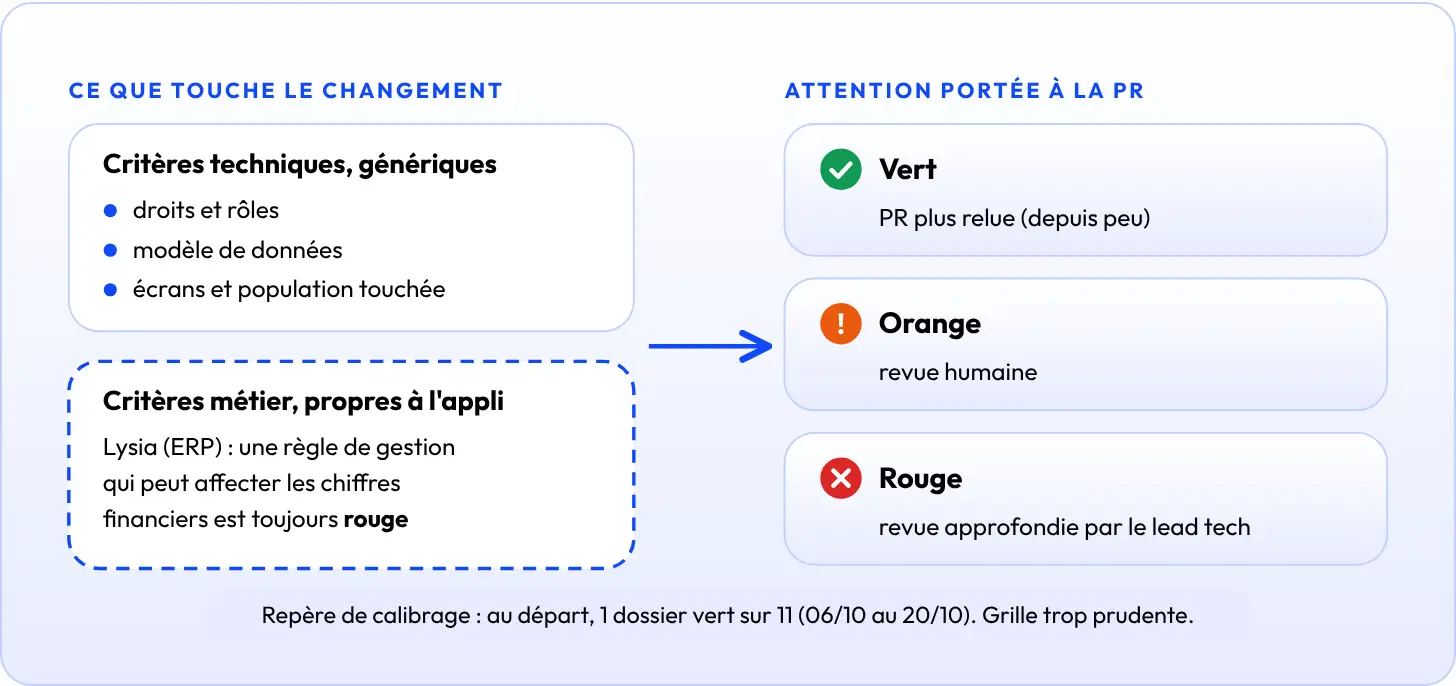
Ma leçon : partez de critères techniques lus dans le code, puis ajoutez les critères métier propres à votre application. Aucune grille générique ne les connaît à votre place. Et calibrez-la dans la durée : une grille qui classe presque tout en rouge empêche toute autonomie.
Le dev ne disparaît pas, son rôle change
On me demande souvent si ce modèle remplace les développeurs. Mon avis : non. Il change leur rôle.
Le dev construit la chaîne. Il modernise l'application, fixe le standard avant que les agents prennent le relais, met en place les tests, définit les exigences avec le PO. Sans ce travail, rien de ce que je décris n'est possible.
Ensuite, il est garant de ce qui part en prod. Il relit les PR, avec une attention qui dépend du risque.
Et un point m'a surpris : valider une PR demande parfois un échange de vive voix. La fiche de changement ne suffit pas toujours. Pourquoi ? Quand l'IA cadre un changement avec moi, elle me demande de trancher : telle option ou telle autre. Je donne ma décision. Mais je dis rarement ce qui m'a fait basculer d'un côté plutôt que de l'autre. L'IA code la décision, sans sa raison. Le développeur voit le choix dans le code. Il ne peut pas deviner le pourquoi, puisque personne ne l'a dicté.
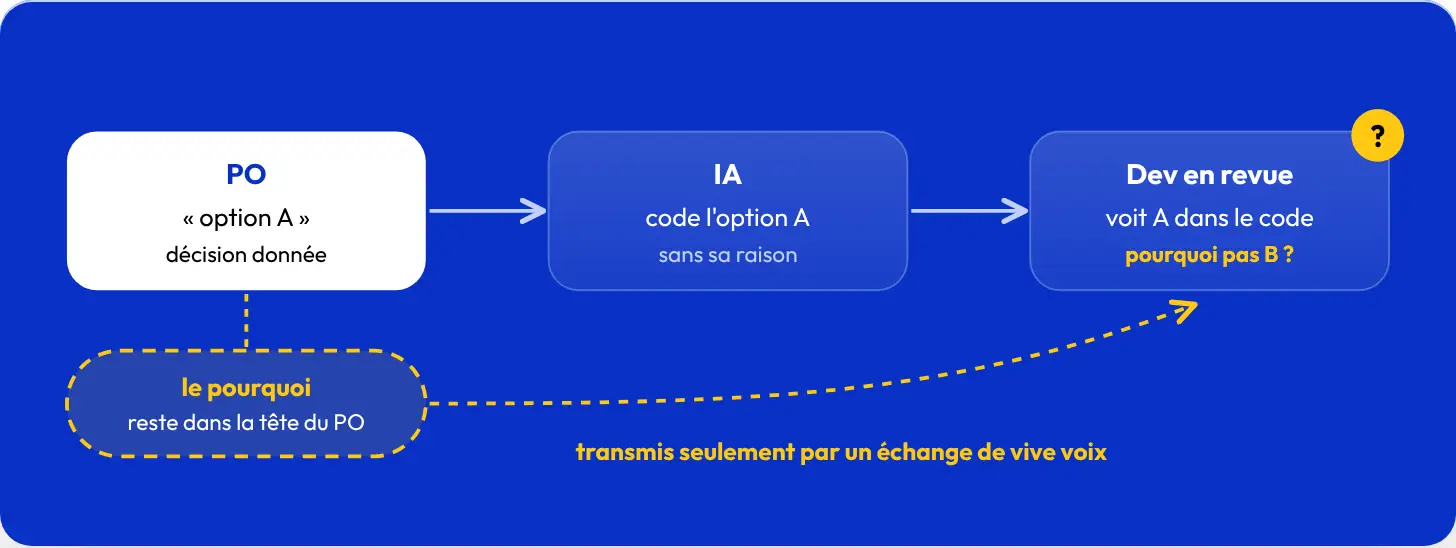
Ma leçon : prévoyez ce temps d'échange dans le flux, quand la revue le demande. Ce n'est pas une perte d'efficacité, c'est ce qui rend la revue réelle. Et prenez l'habitude de dicter le pourquoi de vos choix, pas seulement le choix.
Conclusion
Rendre un PO autonome jusqu'à la prod ne commence pas par l'IA. Cela commence par le flux : repérer où le travail attend. Ensuite, il faut une application lisible : code homogène, documentation, tests à chaque build. Puis un flux écrit, avec la qualité intégrée : recette avant la PR et revue humaine dosée selon le risque. Enfin, une évaluation du risque fondée sur ce que le code touche, complétée par les spécificités métier de l'application, et calibrée dans la durée.
Dans cet ordre, le PO gagne en amont et en réactivité, au prix d'une charge plus forte sur le cadrage et la recette. Le dev ne perd pas sa place : il construit la chaîne et reste garant de ce qui part en prod. Sauter une étape, c'est déplacer le goulot au lieu de le supprimer. Et même bien fait, le goulot se déplace : il faut savoir où il se trouve maintenant.